英伟达(NVIDIA)澄清了为何更新Vera Rubin的规格,并表示新规格更能反映系统在量产状态下的实际持续性能。英伟达Vera Rubin现已进入量产阶段,交付“卓越性能”,并称单个组件规格“并不能决定应用性能”。
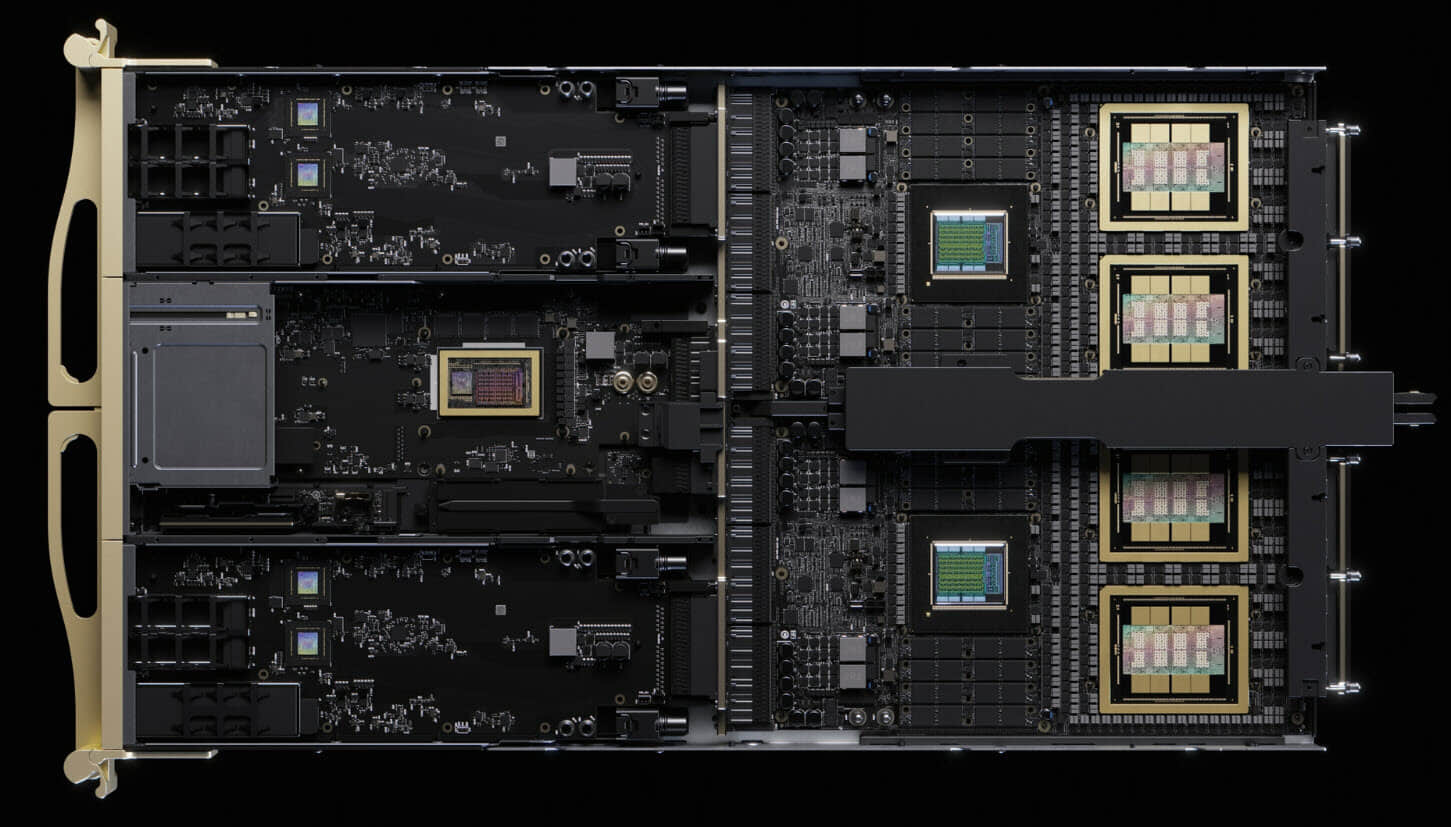
几天前有报道称,英伟达悄然更新了Vera Rubin平台的规格。此次规格调整主要涉及HBM4内存带宽和第六代NVLink带宽。我们联系了英伟达,公司一位代表告诉我们,此次规格变更更好地反映了当前正在量产的系统,并且不影响性能。
Vera Rubin开发期间公布的规格属于初步架构目标。nvidia.com上的最终规格以及Vera Rubin数据表反映的是系统在通过认证的量产状态下的持续性能。——英伟达代表对Wccftech表示
英伟达今年早些时候在GTC 2026上首次发布Vera Rubin平台时,每颗Rubin GPU标称配备288 GB HBM4内存和22 TB/s带宽,同时具备3.6 TB/s的NVLink 6带宽。
在最新规格表中,英伟达现将HBM4带宽下调至19.2 TB/s,NVLink带宽下调至3 TB/s。这意味着HBM4带宽降低了12.7%,NVLink 6带宽降低了16.7%。此次规格调整适用于所有Vera Rubin配置,无论是顶级的NVL72机架还是更精简的NVL8方案。下表展示了新旧规格的差异:
英伟达Vera Rubin规格:旧版与修订版对比
Rubin GPU|HBM4容量:此前288 GB,修订后288 GB,不变
Rubin GPU|HBM4带宽:此前22 TB/s,修订后19.2 TB/s,−12.7%
Rubin GPU|NVLink 6带宽:此前3.6 TB/s,修订后3 TB/s,−16.7%
Vera Rubin超级芯片|HBM4带宽:此前44 TB/s,修订后38.5 TB/s,−12.5%
Vera Rubin超级芯片|NVLink带宽:此前7.2 TB/s,修订后6 TB/s,−16.7%
Vera Rubin超级芯片|网络带宽:此前0.8 TB/s,修订后0.9 TB/s,+12.5%
Vera Rubin NVL72|HBM4容量:此前20.7 TB,修订后20.7 TB,不变
Vera Rubin NVL72|HBM4带宽:此前1,580 TB/s,修订后1,400 TB/s,−11.4%
Vera Rubin NVL72|NVLink带宽:此前260 TB/s,修订后216 TB/s,−16.9%
Vera Rubin NVL72|网络带宽:此前28.8 TB/s,修订后32.4 TB/s,+12.5%
HGX Rubin NVL8|HBM4容量:此前2.3 TB,修订后2 TB,−13.0%
HGX Rubin NVL8|HBM4带宽:此前176 TB/s,修订后130 TB/s,−26.1%
HGX Rubin NVL8|NVLink Switch带宽:此前28.8 TB/s,修订后24 TB/s,−16.7%
HGX Rubin NVL8|网络带宽:此前1.6 TB/s,修订后1.8 TB/s,+12.5%
HGX Rubin NVL8|NVFP4训练:此前280 PFLOPS,修订后270 PFLOPS,−3.6%
HGX Rubin NVL8|FP8/FP6训练:此前140 PFLOPS,修订后130 PFLOPS,−7.1%
让Vera Rubin真正运转起来并不简单;它集成了多颗芯片,以及整套机架、服务器、散热方案、网络、软件、线缆等基础设施。
与上一代Vera一样,英伟达此前提供的规格基于目标值;如今这些平台已进入量产,公司可以向客户提供更精确的规格。Vera CPU也曾被传闻困扰,有说法称公司削减了其内存配置,但事实证明那是假的。
英伟达告诉我们,像更新后的Vera Rubin规格页面上所列的单个组件规格,并不能决定应用性能。
公司表示,Vera Rubin专为智能体AI(Agentic AI)打造,其运行的工作负载在每个任务中需要推理、调用工具、检索和评估数千次。在这种频率下,性能不由单个组件决定,而是取决于数据中心规模。因此,AI工厂规模正是英伟达在AI模型和真实智能体配置上发布帕累托性能的原因。
此外,英伟达表示,迄今为止已发布并可供查阅数月的Vera Rubin第三方基准测试,均是使用量产规格测得的。这些量产规格与当前量产的规格相同。因此,英伟达想表达的意思似乎是:不必担心此次规格变更会影响已经向公众发布的第三方性能评估。
单个组件规格并不能决定应用性能。Vera Rubin专为智能体打造——这类工作负载在每个任务中需要推理、调用工具、检索和评估数千次——在这种频率下,性能取决于数据中心规模,而非任何单个组件。性能提升来自模型、软件、计算、网络和内存之间的极致协同设计,这也是我们针对具名模型和真实智能体配置发布帕累托性能的原因。
Vera Rubin NVL72现已全面量产并出货。第三方智能体基准测试已可供查阅数月,使用量产规格测得的性能表现卓越——每瓦性能提升30倍,每美元token数提升30倍,均优于上一代GB300 NVL72。我们鼓励任何比较平台的人查阅AgentX与SemiAnalysis以及AgentPerf与Artificial Analysis的第三方基准测试。——英伟达代表对Wccftech表示
英伟达更新后的Vera Rubin规格,标志着从早期架构目标向现已全面量产并出货的系统的真实性能转变。
尽管峰值内存和互连数据有所调整,公司强调,应用层面的结果——尤其是对要求严苛的智能体AI工作负载而言——由系统级协同设计驱动,而非任何单个组件。基于这些量产配置测得的现有第三方基准测试,已经反映了该平台强劲的效率提升,让客户清楚了解Vera Rubin如今能带来什么。