一款全新的 GPU 解锁工具释放了英伟达(NVIDIA) RTX 30 与 RTX 40 系列 GPU 的全部潜力,实现了更快的 AI 大语言模型性能与计算能力。Zagitta“GPU-Unlock”工具让英伟达 RTX 30/40 系列 GPU 在 AI 大语言模型中重获新生,计算性能被解锁至原始速率。
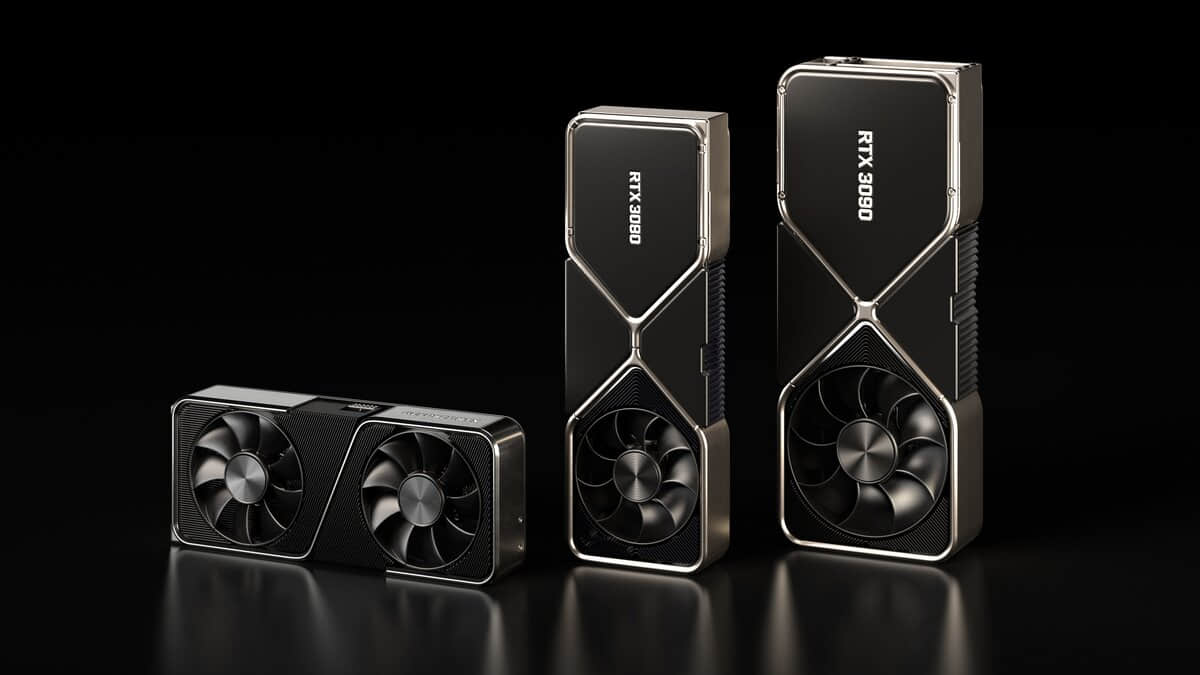
早在加密货币挖矿热潮时期,英伟达曾通过 BIOS 固件和补丁,几乎完全解锁了其 GeForce RTX 30 系列 GPU 的计算性能,并同步推出了专为挖矿设计的 CMP 系列芯片。CMP 显卡同样获得了一款特殊解锁工具,可释放其全部显存能力,容量从 8-10 GB 跃升至 64-80 GB。
尽管改装玩家成功解锁了完整的挖矿速率,但计算限制依然存在。不过,一个名为 Zagitta 的全新开源 GitHub 项目改变了这一局面,它能够解锁 Ampere 架构 GPU 上完整的 BF16/FP16 速率。该工具使用简单,无需刷写 vBIOS,也无需进行硬件改装。
运行该工具的操作十分简单,它可将英伟达 RTX 30 系列在所有 GA102、GA103、GA104 和 GA106 GPU 上的 FP16/BF16 FMA 计算能力提升一倍。
将英伟达 3000 系列显卡的 FP/BF16 指令发射速率解锁至其专业级同等的水平。这一 Linux 内核模块将 CMP 解锁器的 V67/PLM 技术与 UEFI 方案的预驱动时序相结合。它执行解锁操作,写入速度选择器(SS0 0x88888888,用于选择完整 BF16 速率;以及 4 位 SS1 0x8 IMLA4),并在未经修改的英伟达驱动绑定显卡之前执行 FLR。它既不是 UEFI 应用程序,也不是经过修补的英伟达驱动。
这种早期内核模块驱动的优势在于,每次英伟达发布新驱动版本时,都无需手动打补丁。此次解锁的效果是,在 GA102、GA103、GA104 和 GA106 显卡上,将 FP/BF16 FMA 转换为 FP32 运算的指令发射速度提升了一倍。
目前已有许多用户运行该工具,并在 RTX 30 系列 GPU 上观察到最高达 80% 的性能提升。例如,RTX 3090 Ti 的 BF16 能力从 87.5 TFLOPs 提升至 157 TFLOPs,TF32 则从 42.6 TFLOPs 提升至 82.6 TFLOPs。同样,RTX 3080 10 GB 在默认 320W 功耗下,FP16 性能从 65 TFLOPs 提升至 113 TFLOPs。
功耗限制 FP16 BF16 每 MHz
解锁前 300 W 59.6 TFLOPS @ 1384 MHz 63.0 @ 1462 0.043
解锁后,冷启动 380 W 100.3 @ 1208 105.9 @ 1269 0.083
解锁后,热重启 350 W 89.5 @ 1072 95.1 @ 1148 0.083
3090 Ti 在 450 W 下进行密集 8192³ GEMM 运算,采用 FP32 累加,五次采样中位数:
输入 解锁前 解锁后
FP16 87.46 TFLOPS 118.39 TFLOPS
BF16 87.50 TFLOPS 157.41 TFLOPs
TF32 42.58 TFLOPS 82.61 TFLOPS
在 AI 大语言模型中,解锁后的 RTX 30 GPU 能够提供快 33-36% 的预填充(长上下文)输出,同时首词延迟(TTFT)降低了 25%。解码性能未受影响,矩阵乘法性能保持一致。
芯片 显卡 PCI ID 结果 BF16 GEMM 增益
GA102 RTX 3090 Ti 10de:2203 已解锁 +68–80%
GA102 RTX 3090 10de:2204 已解锁 +25–67%
GA102 RTX 3080 Ti 20 GB(OEM,GA102-250)10de:2205 解锁完成,BF16 保持半速率 —
GA102 RTX 3080 10 GB 10de:2206 已解锁 +70–73%
GA102 RTX 3080 20 GB(显存升级版)10de:2206 已解锁 +56–59%
GA104 RTX 3070 10de:2484 已解锁 +73–81%
GA104 RTX 3070 Ti 10de:2482 未使用此模块测试(相同的解锁在 Windows 上通过 UEFI 移植版生效)—
GA106 RTX 3060 12 GB 10de:2504 已解锁 约 +80%
GA103 任意 10de:2414 暂无报告 —
目前,该解锁仅适用于 Linux 平台,尚不支持 Windows。RTX 30 系列 GPU 受益最大,但解锁也延伸至较旧的 GTX 9、GTX 10 和 RTX 20 系列显卡。
即便是 RTX 40 系列 GPU 也能从这些新解锁中获得提升。其他用户还在较旧的 RTX 30 系列显卡(如 24 GB 的 RTX 3090)上微调模型。据报道,一位用户在 Qwen3.8-27B 上达到了每秒 381 个 token 的吞吐量。
该 AI 模型的基线性能为 82 TPS,通过优化 MTP、带上下文查找的 DFlash2 以及优化的查找验证,提升至 4.6 倍速率。我们本周报道了这一消息,而随着模型在旧显卡上持续得到优化,其价格也在上涨。
例如,英伟达 GeForce RTX 3090 24 GB 此前售价约为 1000美元,但自这些报道出现以来,价格已攀升至 2000美元以上。
RTX 3090 Ti 正快速逼近 3000美元大关,而 RTX 3080 10-12 GB 型号在 eBay 上的售价已达到 900-1100美元。这些优化让 Ampere 显卡在游戏之外重获新生,但这也意味着原本计划购买二手 RTX 30 显卡的玩家,如今不得不面对因 AI 需求而飙升的价格。
这款解锁工具正为 Ampere 时代的 RTX 30 显卡在 LLM 工作负载中注入新的活力,带来可观的计算增益,使其在无需任何硬件改装的情况下,更适合用于推理和微调。虽然性能提升对 AI 爱好者而言是明显的利好,但由此产生的需求正大幅推高二手市场价格,让曾经平价的游戏 GPU 变成了炙手可热的 AI 加速器,也让纯游戏玩家更难入手。