英伟达(NVIDIA)的Vera CPU让Modal在智能体AI沙箱中的性能提升了一倍,超越英特尔(Intel)和AMD的CPU。Modal为了迁移到英伟达的Vera CPU不得不进行大规模改造,因为此前一直依赖x86芯片,但这次转变带来了两倍的性能提升。
英伟达Vera CPU正在持续改变市场对Arm架构CPU在智能体AI应用场景中的认知。Arm自身也强调了其AGI CPU相较x86方案的诸多优势,而英伟达的方案似乎正迅速成为许多此前运行x86芯片的公司的首选。
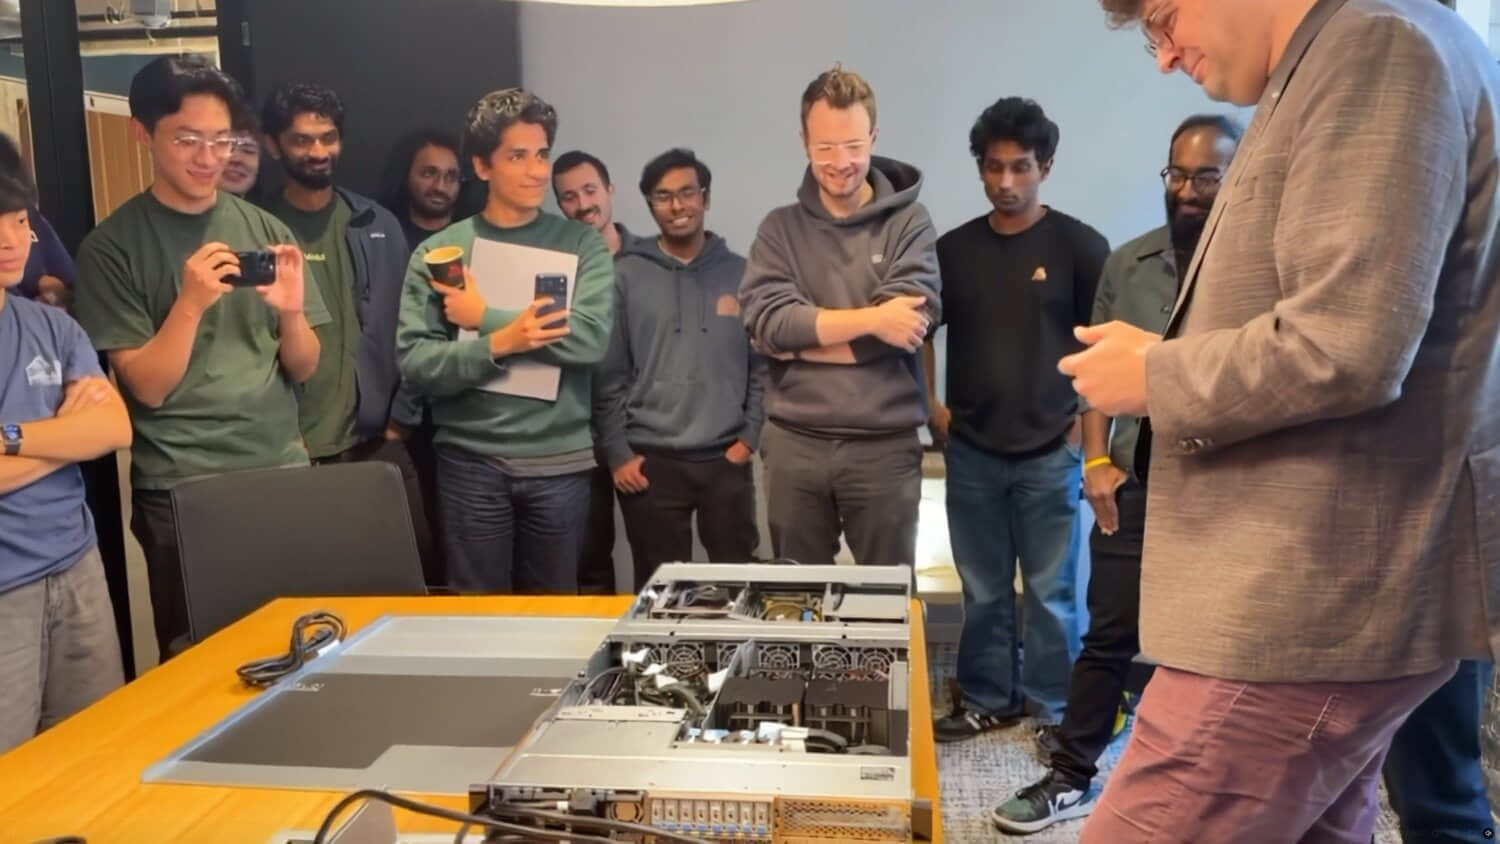
Modal就是其中一家,该公司最近在旧金山办公室收到了首批Vera CPU服务器。此前,该公司一直完全依赖搭载AMD和英特尔芯片的x86系统,因此转向Arm生态需要对基础设施和镜像构建系统进行调整。
尽管改造过程颇为费心,Modal仍称迁移到英伟达Vera令人印象深刻,其智能体AI沙箱的AI吞吐量提升了一倍,并称其为“极具吸引力的选择”。
在大多数系统中,吞吐量和延迟是一对权衡关系。延迟可以定义为任务从开始到结束所经过的时间。吞吐量则是单位时间内完成的任务数量,用于测试主机系统并发交错处理各进程、同时推进所有任务的能力。任务打包越密集,吞吐量越高。但一旦CPU被完全占满,由于资源争抢,单个任务的延迟就会受到影响。
就Modal调度器而言,我们总是忍不住想以更高的打包密度运行,从现有主机中榨取更多性能,并为用户提供更高的绝对规模。但正如容器内的工作负载存在尖峰波动,集群中容器的绝对规模同样会波动,这让我们面临主机超载的风险。
为了测试英伟达Vera,Modal构建了一套具有代表性的智能体沙箱工作负载和基准测试,其中包括开发“Agentless Agent Bench”,收录了50个Terminal-Bench标准解法与验证器。该基准测试同时给出线性完成时间和并发吞吐量数据。
首批测试显示,Vera相较x86芯片有明显提升,但这些测试是在空载条件下运行的,本质上只是纯粹的直线延迟测试。
在负载条件下,英伟达Vera CPU完全展现出另一番实力。在吞吐量方面,Vera相较同级别的英特尔至强“Granite Rapids”芯片提升了一倍。这一领先优势源于一个事实:与x86 CPU不同,Vera不会随着任务堆积而变慢,而是以原有速度逐一高效处理。
结果不言自明:
对比英特尔至强:单核任务吞吐量最高提升一倍。对比AMD EPYC:在150个并发容器、每套系统启用124个逻辑CPU的条件下,任务吞吐量提升超过6倍。
Vera的杀手锏在于抗争抢能力。其高内存带宽允许每核打包显著更多的容器工作负载,且不会出现CPU降频——这也解释了为何Vera在我们的基准测试中大幅领先其他方案。
在CPU数量增加时,其他方案很早就触及吞吐量瓶颈,而Vera则持续提升,这表明我们或许能将其推到比测试所用节点更高的水平。Modal迁移到英伟达Vera CPU,尽管需要从x86进行大量基础设施和镜像构建改造,但在智能体AI沙箱中实现了明确的2倍吞吐量提升。
在负载条件下,得益于高内存带宽和每核打包更多并发工作负载的能力,Vera保持了强劲性能,没有出现英特尔和AMD CPU常见的降频现象。最终,这成为一个极具吸引力的Arm架构方案,能够更高效地扩展,应对高密度、高争抢的智能体工作负载。