RTX 5090几乎已从英伟达(NVIDIA)的官方商城中销声匿迹,而RTX 6000 PRO又价格高昂,难以在每台大语言模型(LLM)主机中见到。这一局面为Tesla V100的强势回归提供了绝佳机会。该卡配备32GB HBM2显存,提供PCIe与SXM2两种规格,适合希望以合理成本运行本地AI模型的用户。可惜凡事总有代价——在高端显卡对普通买家遥不可及之际,Tesla V100的价格被加上了200美元的溢价。
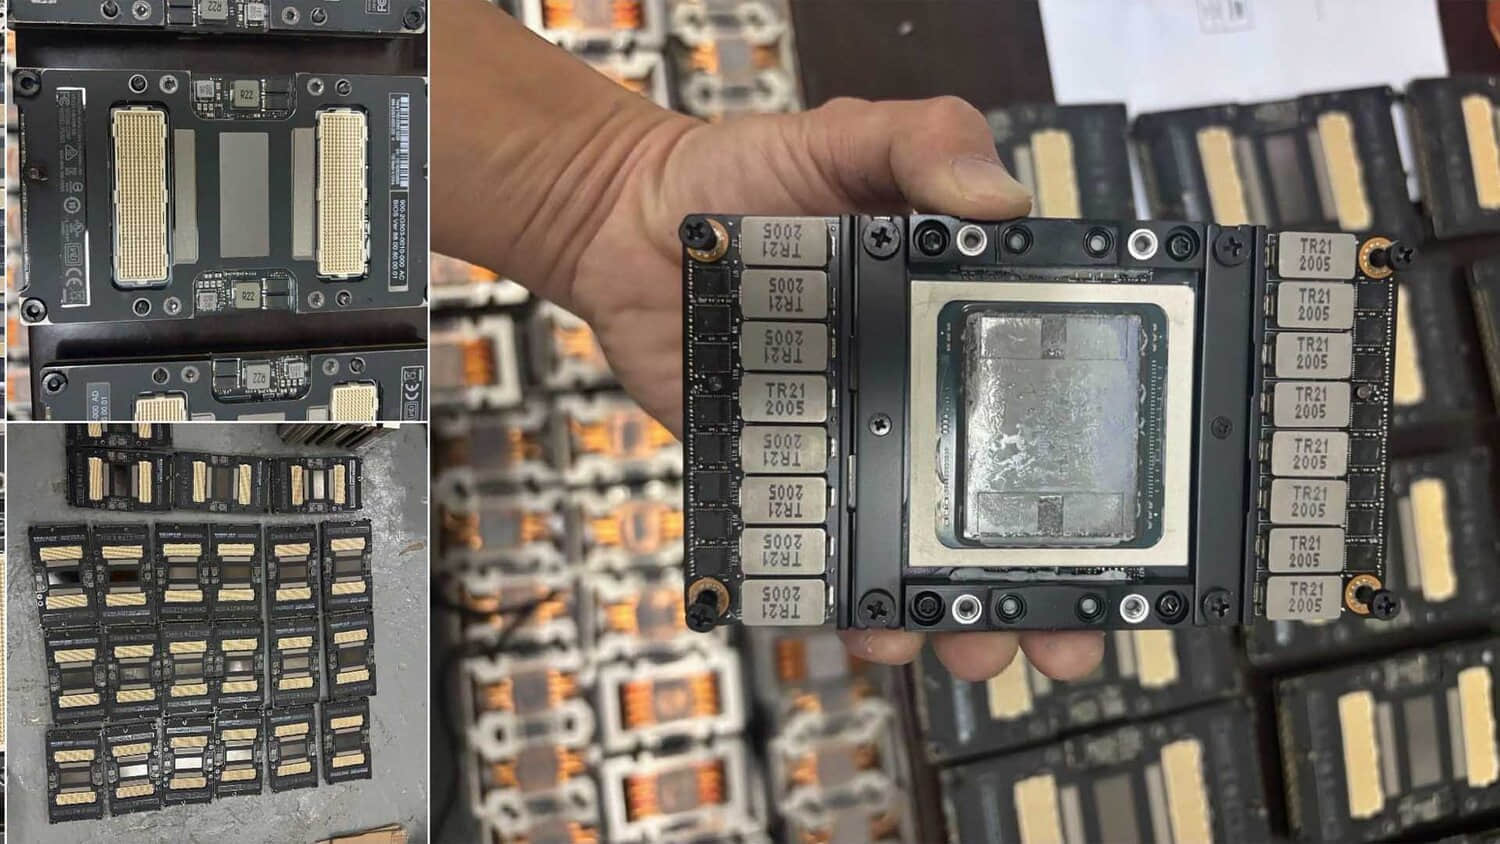
对于一块已有9年历史的显卡而言,Tesla V100拥有可观的带宽与显存,足以以RTX 6000 PRO价格的一小部分运行性能尚可的大语言模型。
@unbug在X平台上发布的一则帖子透露,Tesla V100正被重新改造并以整车装载的方式出货,用于推理场景,因为对于希望以约2,000美元组建大语言模型主机的用户来说,它的规格相当出众。尽管这一数字仍偏高,但显然优于购买RTX 6000 PRO这类产品——后者在8月份时价格已突破16,000美元。
其中一张图片显示,Tesla V100已被改装上三风扇散热器,使其更易安装到配备PCIe插槽的传统主板上。该卡最初采用SXM2接口,于2017年5月首次发布时专为服务器主板打造。同年稍晚推出的PCIe 3.0 x16版本则消除了兼容性障碍。
尽管价格上涨了200美元,Tesla V100在运行AI模型方面依然实力不俗。凭借900GB/s的内存带宽,这块老将应对token生成与提示词处理绰绰有余。事实上,我们曾报道过,在使用NVLink主板将四块Tesla V100组合起来时,该配置在Qwen3.8-Flash-Next基准测试中,相较M5 Ultra与双DGX Spark单元,性能提升最高可达230%。
还有一位幸运玩家成功改造了SXM2版本的Tesla V100,通过SXM2转PCIe转接卡,让这块显卡与自己的RTX 4080协同工作,从而以尚可的token生成速度运行Qwen3.6-27B等270亿参数模型。对于那些渴望搭建正经大语言模型主机、又不愿砸下重金的用户来说,这老实说是目前最“划算”的显卡。可惜无人能预料Tesla V100还会被加价多少,所以如果你在当地找到卖家,就尽快大胆出手吧。