Qwen3.8-27B是一款性能强大的AI模型——前提是你的VRAM和系统内存足够充裕。在M4 Pro MacBook Pro上,其24GB统一内存在运行该AI模型时,会成为预填充速度的瓶颈。所幸,一位用户通过USB-C接口将一部iPhone 17 Pro Max连接到这台便携式Mac上,并借助自定义软件,使同一AI模型的预填充性能提升至多44%。
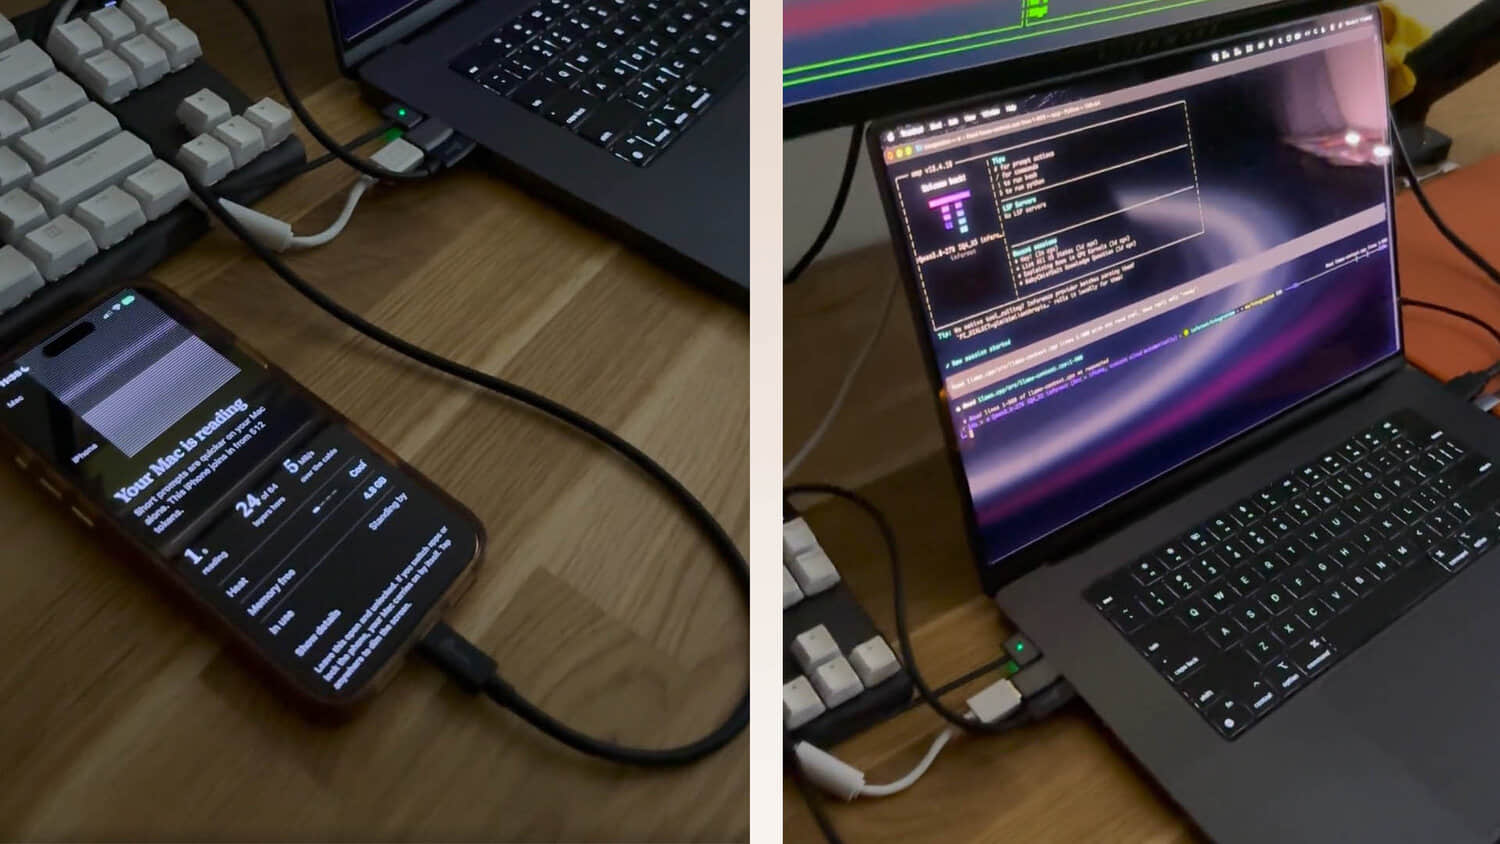
即便将内存提升至20,480MB,M4 Pro MacBook Pro仍受限于64K上下文窗口,这使得iPhone 17 Pro Max成为必要之举。
为了绕过Mac的24GB统一内存限制,Reddit用户“u/StayLameBro”通过两种方式将工作负载分配到Mac和iPhone 17 Pro Max上。在预填充加速方面,MacBook Pro运行每批256个token的第1至40层,并将激活值流式传输到手机上。而iPhone则在其A19 Pro的GPU上运行第41至64层,同时Mac开始处理下一批。GPU的加入使手机的性能比不使用时快了约2.4倍。
神经网络引擎在这里也没有闲着,每16K的旧上下文都会被编译成一个神经网络引擎模型,与单独使用A19 Pro的GPU相比,在140k上下文下将每token写入时间从279毫秒缩短至176毫秒。至于将2,000个token文件预填充到已保存会话中的性能表现:在8K上下文下,仅Mac的吞吐量为132 tok/秒,而配合iPhone后达到177 tok/秒,提升35%。在16K时,从109 tok/秒升至157 tok/秒,增幅高达44%。
在32K上下文窗口下,预填充速度从101 tok/秒提升至130 tok/秒,改善幅度为29%。将一部iPhone 17 Pro Max连接到M4 Pro MacBook Pro上,人们或许会认为通过运行自定义软件就能获得惊人的预填充速度。遗憾的是,这属于“好得不像真的”的情况,因为这位Reddit用户指出了若干限制。例如,手机在64K以下并不会加速文本生成,这部分仍然由Mac负责。
另外值得一提的是,为iPhone 18 Pro和iPhone 18 Pro Max提供动力的A20 Pro可能带来更多性能余量,这不仅是因为其性能更强,还得益于其双16核神经网络引擎——据称在为NPU专门定制的任务上,其吞吐量高于该SoC的7核GPU。这款自定义软件目前是开源的,可从GitHub下载,名称为“backburner”。
即使只是一次实验,你也能看到预填充速度的提升带来了可观的收益。当然,其能力还可以进一步探索,不过这也可能意味着像iPhone这样的设备会进入与DRAM和SSD相同的短缺时代。