WiCi发布了全球首款无线本地GPU解决方案——WiCi One,可通过WIFI共享专用GPU的算力。需要一块随时可用、通过WIFI无线连接的专用GPU?WiCi One帮你搞定,最高支持RTX 5090。
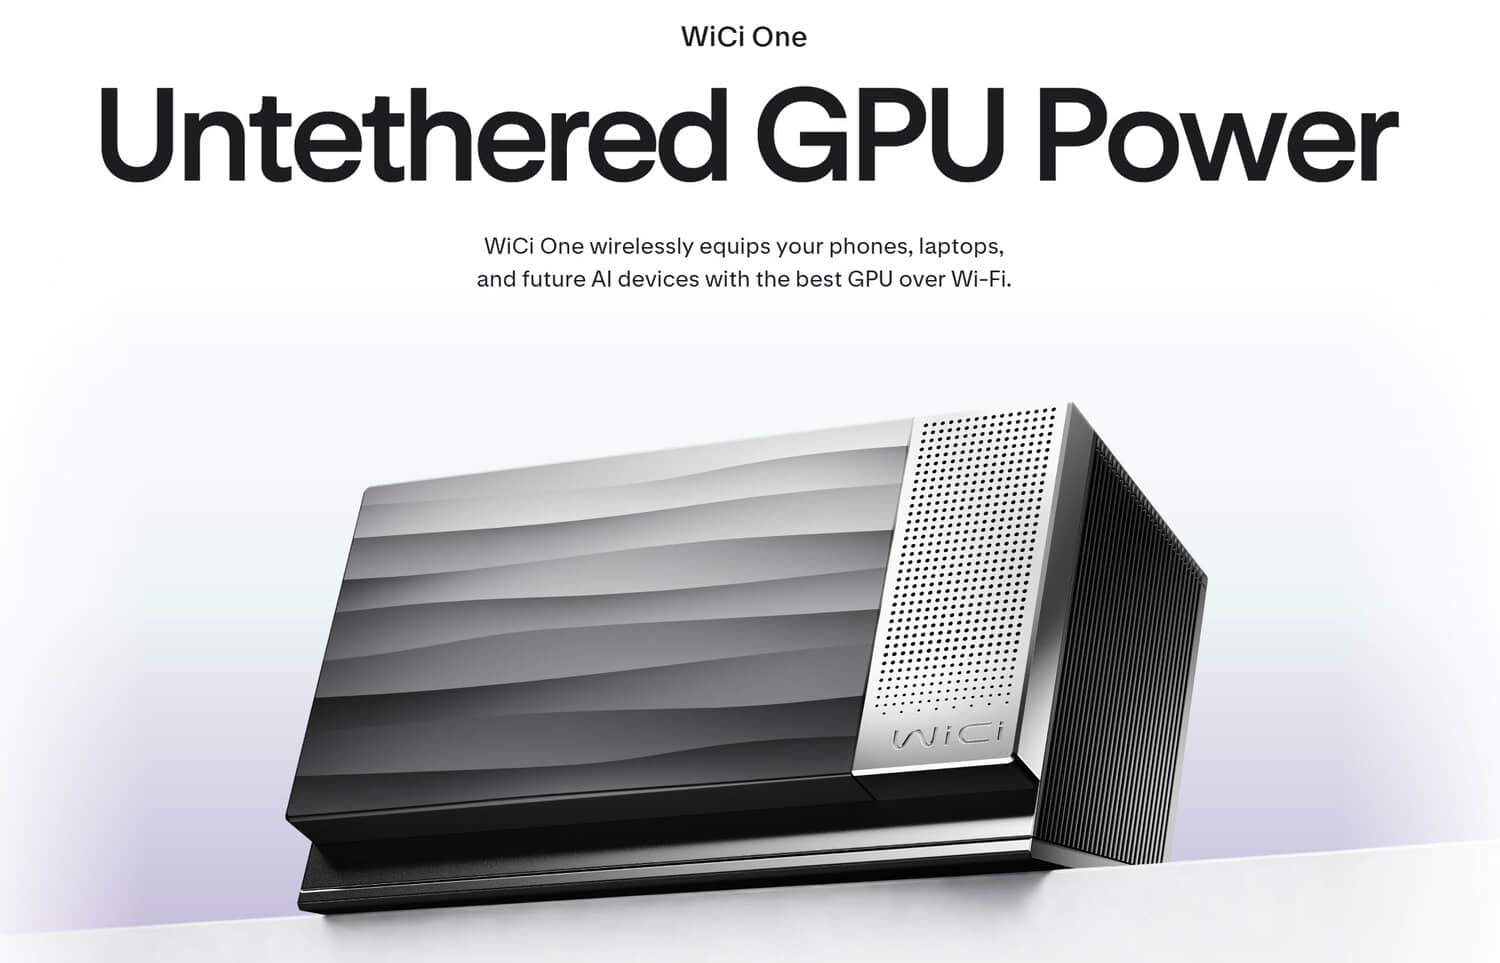
集中式共享计算方案近来风头正劲。我们已经见过英伟达(NVIDIA)的Pair这类产品,它能让家庭和办公室内的闲置算力资源池化共享;但如果是完全无线的方案,提供一块可专门用于AI任务的专用GPU呢?
这正是WiCi One的用武之地。该方案出自Vincross Hexa机器人和获得红杉资本投资的Vesta Sleep背后的团队之手。WiCi团队将WiCi One称为无线本地GPU设备,在驱动模式下会以标准本地GPU的形式出现,或作为即插即用的API端点供应用调用,无需修改任何代码。在深入细节之前,先看几个关键亮点:
不受限的本地AI:别再租用AI算力了。在家就能运行海量开放权重模型(最高750B+参数,如Kimi K3、DeepSeek v4.1和Gemma 4)。无使用上限、零订阅费、数据完全私密。
在瘦客户端上流畅运行重型媒体与游戏:在轻量级入门笔记本上以70+ FPS串流《赛博朋克2077》(Cyberpunk 2077)等3A大作,或加速Premiere Pro和DaVinci Resolve的时间线渲染。
无缝集成:具备驱动模式(向操作系统呈现为标准本地GPU)和API模式(将现有AI应用连接至本地算力)。
次世代硬件:配置从英伟达RTX 5060 Ti(16GB VRAM)到RTX 5090(32GB),可通过Wi-Fi 7在多台设备间共享。
就设备本身而言,WiCi One是一个全封闭式方案,内置标准GPU。上市时,该方案将提供搭载英伟达RTX 5060 Ti 16 GB GPU的版本,同时也在规划RTX 5090 32 GB版本。CPU方面,5060 Ti版本将搭载Core 3 100U,而5090版本将搭载Core Ultra 7 255H。5060 Ti版本配备1 TB存储,5090版本则为4TB。
有趣的是,虽然该系统将采用统一分层内存方案,但5090型号可通过TurboStream权重分页将4 TB的NVMe转化为可用VRAM。
为展示该方案的潜力,WiCi列出了多款万亿参数级LLM的TPS(每秒Token数)。此外,公司还展示了部分游戏数据,《赛博朋克2077》运行帧率超过100 FPS。
无线AI计算
GPU:英伟达RTX 5060 Ti · 16GB GDDR7(5060 Ti版);英伟达RTX 5090 · 32GB GDDR7(5090版)
空中计算GPU共享
CPU:Intel Core 3 100U(5060 Ti版);Intel Core Ultra 7 255H(5090版)
Wi-Fi:Wi-Fi 7 · 4×4 MIMO · 320MHz路由器级空中链路多链路传输
完全灵活的GPU运行时
驱动模式:WiCi虚拟GPU支持macOS、Windows和Linux;零往返缓存与追踪回放
SDK模式:Python · JavaScript · Swift;开箱即用推理,支持多模态
API模式:兼容OpenAI端点;现有客户端即插即用
统一分层内存
存储:NVMe 4 · 1TB(5060 Ti版);NVMe 5 · 4TB(5090版);Turbo Stream权重分页可将最高4TB的NVMe转化为可用VRAM
LLM:万亿参数模型:Kimi K3 · 2.8T · 5 tok/s;DeepSeek V4 Flash · 284B · 20 tok/s;Gemma 4 · 26B · 500+ tok/s;在WiCi One 5090版上实测,接近云端20–40 tok/s的水平
这些只是几个演示,主要问题在于无线接口本身。eGPU外接盒与WiCi One的区别在于算力的传输方式。eGPU通过USB或OcuLink等物理接口传输,而WiCi One则通过Wi-Fi 7(4x4 MIMO - 320 MHz频段)传输。
在这一点上,WiCi使用自家协议和网络例程来缓解无线的部分缺陷,但归根结底,这仍有待真实测试环境的检验。WiCi One纸面参数听起来很惊艳,但真实数据需要通过经过验证的独立测试来呈现。WiCi One起售价为2,599美元,但早期注册用户可享受折扣,价格降至1999美元。