华为发布了其下一代昇腾芯片及超节点路线图,涵盖昇腾960DT/PR、昇腾970和昇腾980加速器。华为加速推进AI加速器路线图,新一代昇腾芯片提前登场。
在2026年华为全联接大会上,华为公布了最新的昇腾与Atlas路线图,展示了多款下一代芯片与技术。核心要点是,华为将加速推进其AI基础设施路线图,以满足日益增长的行业需求,共有四款即将推出的芯片值得关注。
从芯片开始说起,昇腾将首先推出其下一代昇腾960DT,作为昇腾950芯片的继任者。该芯片将采用全新的SIMD/SIMT架构,支持FP32、HF32、FP16、BF16、FP8、MXFP8、HiF8、MXFP4和HiF4等一系列数据格式。“H”系列格式兼顾精度与动态范围,能够以单一格式替代两种标准浮点数据格式。
该芯片将具备高达2 PFLOPs的FP8算力和4 PFLOPs的FP4算力。内存方面,该芯片将配备288 GB HBM,运行速率为9.6 TB/s,较昇腾950系列提升2.4倍,芯片间互联带宽为2.2 TB/s。
继昇腾960DT发布之后,华为还将于2027年第三季度推出昇腾960PR芯片。该芯片将具备更快的推理能力,FP4总算力提升至8 PFLOPs。该芯片将配备更精简的192 GB HBM,带宽为2.4 TB/s。互联带宽保持在2.2 TB/s。
展望2027年之后,华为还规划了两款芯片——昇腾970和昇腾980。昇腾970将是又一次重大架构升级,具备高达3.6 PFLOPs的FP8算力和14 PFLOPs的FP4算力。该芯片将配备288 GB HBM内存,运行速率达14.4 TB/s。这表明其采用了比HBM3/E更新的HBM标准。互联带宽也将翻倍至4.4 TB/s。
华为提出,2028年其昇腾980芯片将在前代产品的基础上继续演进,将算力提升至7.2 PFLOPs FP8和28 PFLOPs FP4。该芯片将配备384 GB HBM内存,带宽达38.4 TB/s,互联带宽为8 TB/s。华为提到,这些是昇腾980芯片的初步规格,临近发布时可能会有所调整。
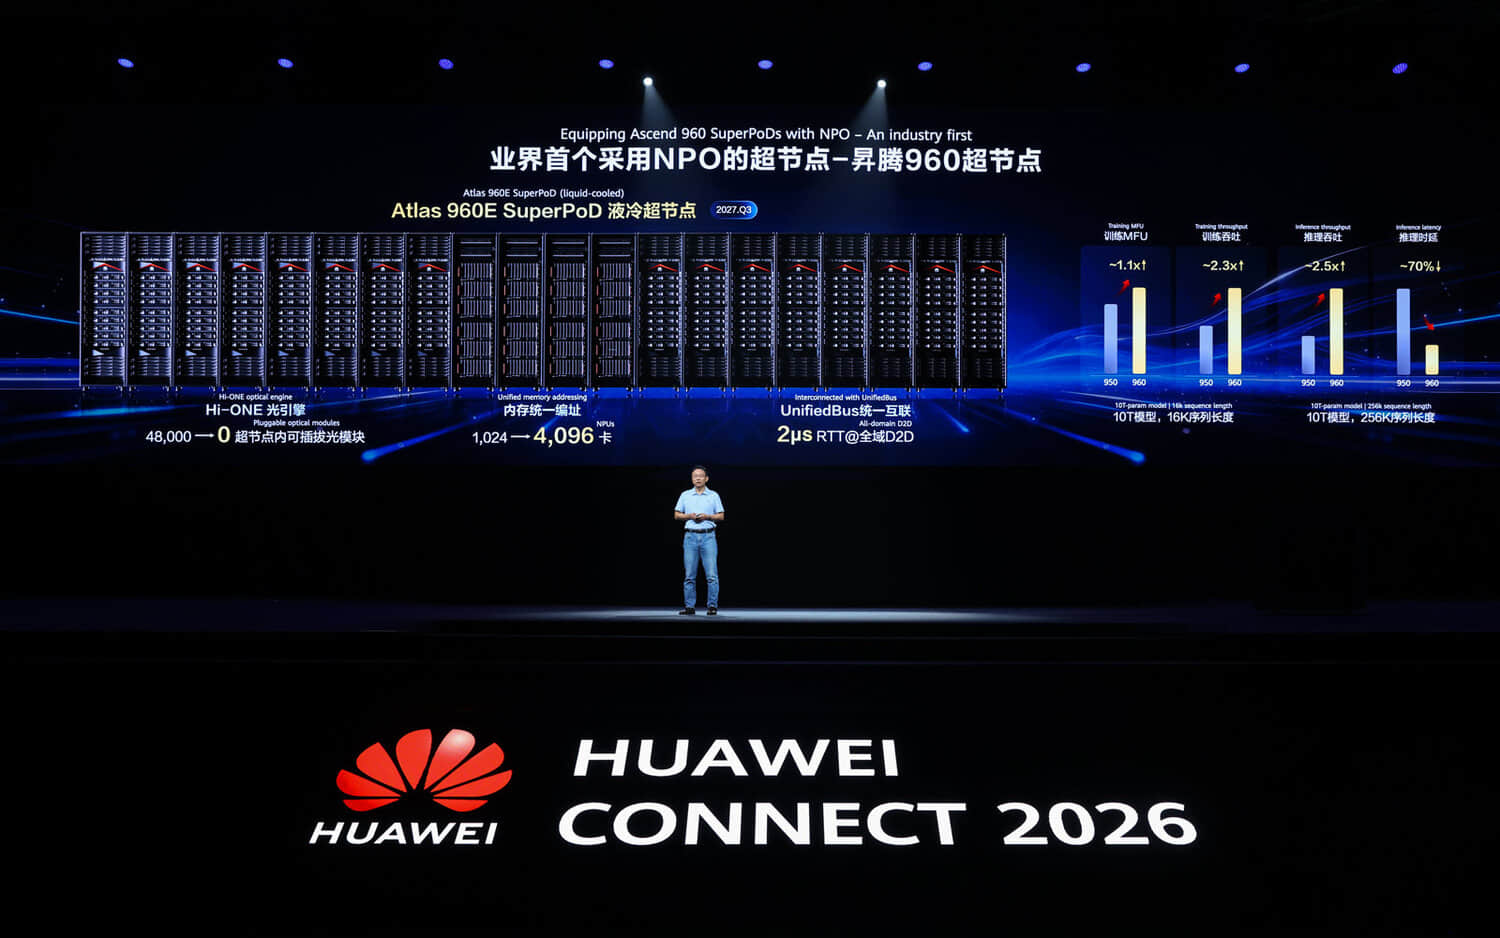
华为Atlas 960E SuperPoD也已发布,成为业界首个采用NPO(近封装光学)的解决方案,具备7.2 Tbps的快速传输速度。该方案计划于2027年第三季度发布,将采用液冷散热。该系统将提供8 Exaflops的FP8和16 Exaflops的FP4算力性能。
这是首个采用NPO(近封装光学)的超节点,通过华为的Hi-ONE光引擎实现(每引擎7.2 Tbps)。
4,096个NPU,统一内存寻址
8 EFLOPS FP8 / 16 EFLOPS FP4
部分官方简报中提及约1 PB HBM;具体取决于统计口径(封装内HBM还是更大的超节点内存架构),也引用了256 TB统一内存池
约5,500个Hi-ONE模块替代数万个800G可插拔光模块,节省超过550 kW功耗,可用性宣称达99.8%
对比Atlas 950:在10T参数模型示例中,训练吞吐量约为2.3倍,推理吞吐量约为2.5倍,推理延迟降低约70%
通过RoCE或灵衢实现多超节点集群:最多512,000个加速器,多轨拓扑下可达100万个
该系统将采用Hi-ONE光引擎,总共配备4096个NPU,支持统一内存寻址。系统将采用最新的UnifiedBus互联,在全域D2D环境下提供2微秒的RTT。利用5,500个Hi-ONE NPU模块,功耗降低超过550kW。整个系统将配备庞大的256 TB统一内存池。
与现有的Atlas 950超节点相比,960E在AI训练工作负载(10T参数模型,16K序列长度)中吞吐量提升高达2.3倍,在AI推理中(10T参数模型,256K上下文长度)吞吐量提升高达2.5倍。该系统在推理工作负载中还将延迟降低了70%。
此外,华为还将支持多个Atlas 960E超节点通过RoCE或灵衢互联,构建最多512,000个加速器的超级集群,多轨拓扑集群下可达100万个。
华为还在应对日益增长的KV缓存需求,推出了OceanStor M900 AI内存与存储解决方案,利用灵衢网络构建“一跳直达”的PB级全局KV Cache多级缓存方案。OceanStor M900将超节点的KV Cache从VRAM和内存扩展至SSD。单集群可提供64PB容量,单个NPU的可用KV Cache容量从GB级提升至TB级,允许保存、共享和复用更多上下文,显著提升KV Cache命中率。
OceanStor M900融合了CPU、网络和磁盘控制器,使超节点实现从NPU到SSD的一跳直达访问,避免协议转换和CPU转发。访问延迟从毫秒级降至60微秒,降低了90%。单集群可提供40TB/s的聚合访问带宽,华为声称这一数字比行业标准高出1.5倍。
所有这一切表明,华为不再等待单一旗舰芯片:它将昇腾960系列提前,并锁定了通往970和980的年度路线。更大的看点在于Atlas 960超节点,它采用NPO光学技术并集成数千个NPU,将规模、内存和互联转化为真正的性能增益。如果路线图如期推进,华为的赌注很明确:用更快的系统和更深的集群赢得AI竞赛,而不仅仅是更快的芯片。