英伟达(NVIDIA)展示了其在Vera Rubin平台上实现的能效优化成果,这些优化带来了词元吞吐量的提升。英伟达在AI基础设施峰会上披露了其Vera Rubin平台的大幅能效提升。
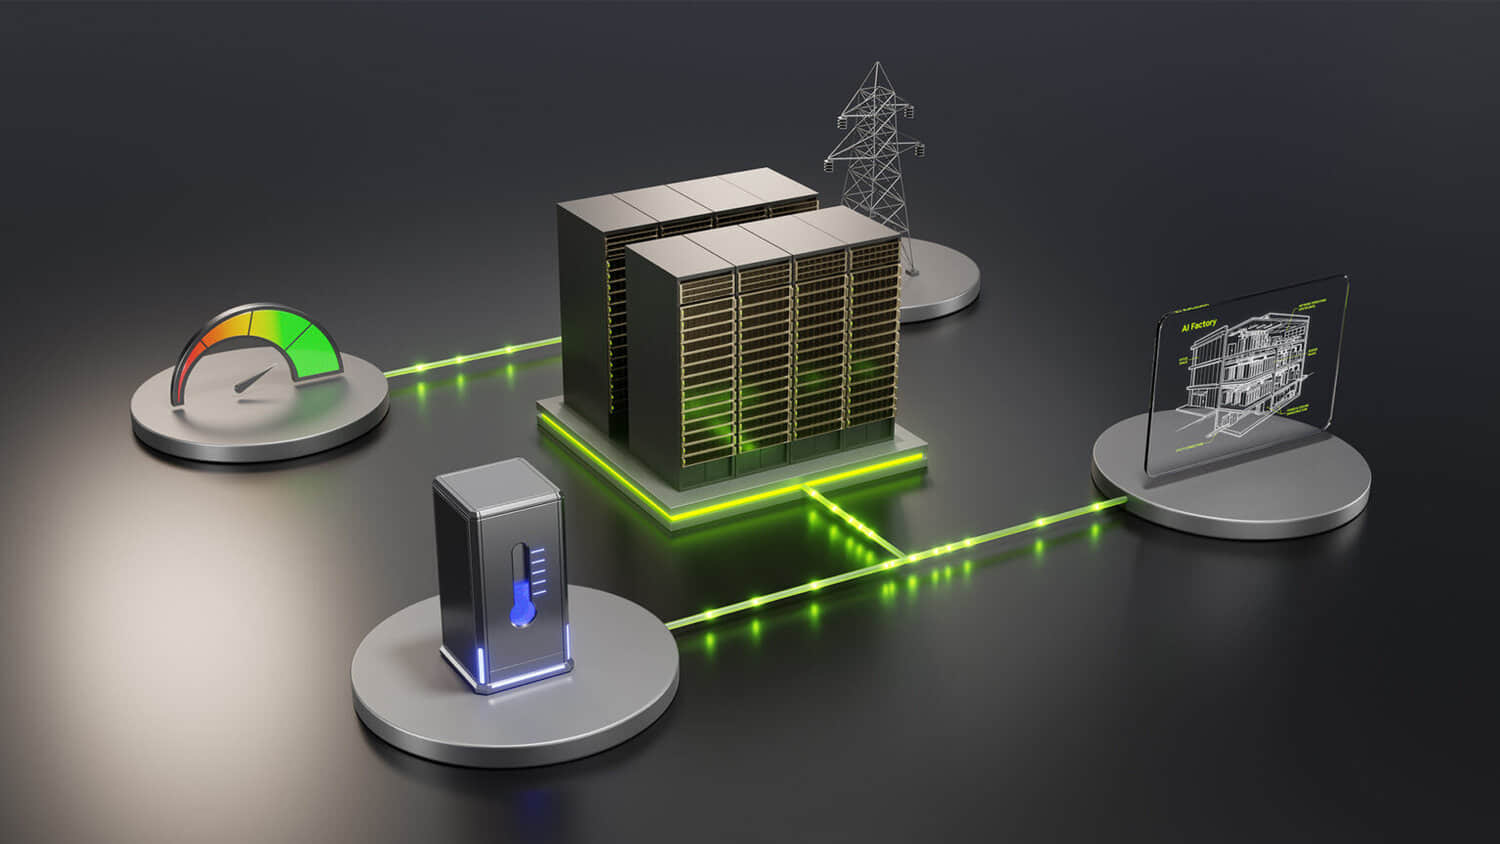
AI需求持续给能源基础设施带来沉重负担。为应对这一挑战,英伟达正在其全栈AI工厂平台框架下推出一系列广泛解决方案,涵盖Vera Rubin系统、Dynamo推理软件、NeMo库,以及包括用于纵向扩展计算的NVLink、用于以太网的Spectrum-X、用于连接数千节点的ConnectX SuperNIC、基于BlueField的上下文内存存储,以及用于基础设施安全的BlueField DPU在内的多种网络解决方案。
为确保AI工厂实现尽可能高的词元吞吐量,英伟达的DSX MaxLPS可将每兆瓦词元吞吐量提升最高40%。DSX已被Emerald AI应用于其Conductor平台,这正是DSX所提供电网编排能力的一个范例。
借助DSX Flex,Conductor AI平台可根据电网状况动态调整数据中心的电力需求。该平台的目标是在电网受限时降低用电需求,确保关键AI工作负载不中断。
迄今为止,该工厂已根据电网状况接收了200个信号,每次都在无需用户干预的情况下完美运行。此外,Lambda等云服务提供商已对该平台进行了测试,发现在固定电力预算下词元吞吐量提升了24%。
Lambda是一家GPU云服务提供商,服务超过10,000家客户,涵盖AI原生初创公司到超大规模企业。该公司在一个五机架、19节点的集群上运行了该软件。
他们的发现是:在相同电力预算下运行19个节点(而非满功率运行16个节点),Lambda实现了集群范围内词元吞吐量提升24%——从约每秒400万词元提升至500万。每瓦性能提升了23%。
这些收益转化为Vera Rubin和Groq 3 LPX机架更高的词元吞吐量:
在相同站点电力范围内可容纳最多40%更多的GPU
词元吞吐量最高提升35%——无需新增电力线路
数字说明了一切。在10万上下文窗口的Qwen 3.8 27B工作负载上,Groq 3 LPX实现了每用户每秒2,529个输出词元。这一余量让智能体能够在相同的响应预算内运行更多推理步骤和工具调用,即使工作负载规模扩大也不受影响。
全球各地的初创公司也在反馈他们对英伟达Vera CPU的使用感受。多家AI公司的早期结果显示,与其他CPU相比,性能提升最高达1.9倍,延迟大幅降低,吞吐量提升73%,查询任务吞吐量提升3.3倍。
Perplexity为其面向智能体AI的全新SPACE安全沙箱平台对Vera CPU进行了基准测试,结果显示沙箱启动速度提升1.9倍。
Daytona让Vera CPU运行智能体工作负载,称其“为智能体执行带来了显著收益”。
ClickHouse分享了Vera CPU在其分析数据库开放基准测试ClickBench上的结果。Vera是该团队迄今测得的最快机器。ClickHouse表示,这“强烈预示着面向数据密集型工作负载的CPU性能未来走向”。
DeepInfra在Vera CPU上运行了多项基准测试,显示其在所有指标上均胜出,包括编排步骤延迟降低2.2倍。
Prime Intellect发现,随着更多工作负载并行运行,Vera CPU仍能保持高带宽和低且一致的内存延迟——这正是智能体AI所需的可预测性能。
Redpanda表示,其对Vera CPU的基准测试显示,延迟比其他CPU低5.5倍,吞吐量高出73%。
Starburst发布的基准测试结果显示,Vera CPU的查询吞吐量比其他CPU快3倍。
Kinetica发现,与传统CPU相比,Vera CPU的分析查询性能提升2.7倍。
英伟达及其合作伙伴正在将数据中心重塑为协同设计的AI工厂,衡量标准不再是峰值FLOPS,而是经验证的每兆瓦词元数。从Annapurna的NVHBM工作、d-Matrix的NVLink Fusion集成,到Emerald AI与Silicon Valley Power合作的电网灵活负载项目、Lambda借助DSX MaxLPS实现的23%每瓦性能提升、Pinterest的Blackwell加Dynamo视觉AI、Vera Rubin NVL72的30倍AgentX吞吐量,以及Groq 3 LPX的极致延迟优势,再加上一波Vera CPU的胜利和NVLink 6的工厂级弹性。
传递的信息始终一致:从芯片到软件再到电网的全栈系统能够提取更多词元、保护优先工作负载,并让每一兆瓦发挥更大价值,将受限的电力转化为更高容量、更低的每词元成本,以及为下一代AI基础设施创造更多经济价值。