英伟达(NVIDIA)刚刚发布了其定制HBM解决方案,名为NVHBM,该方案将用于未来的GPU,提供更高的带宽和更低的功耗。
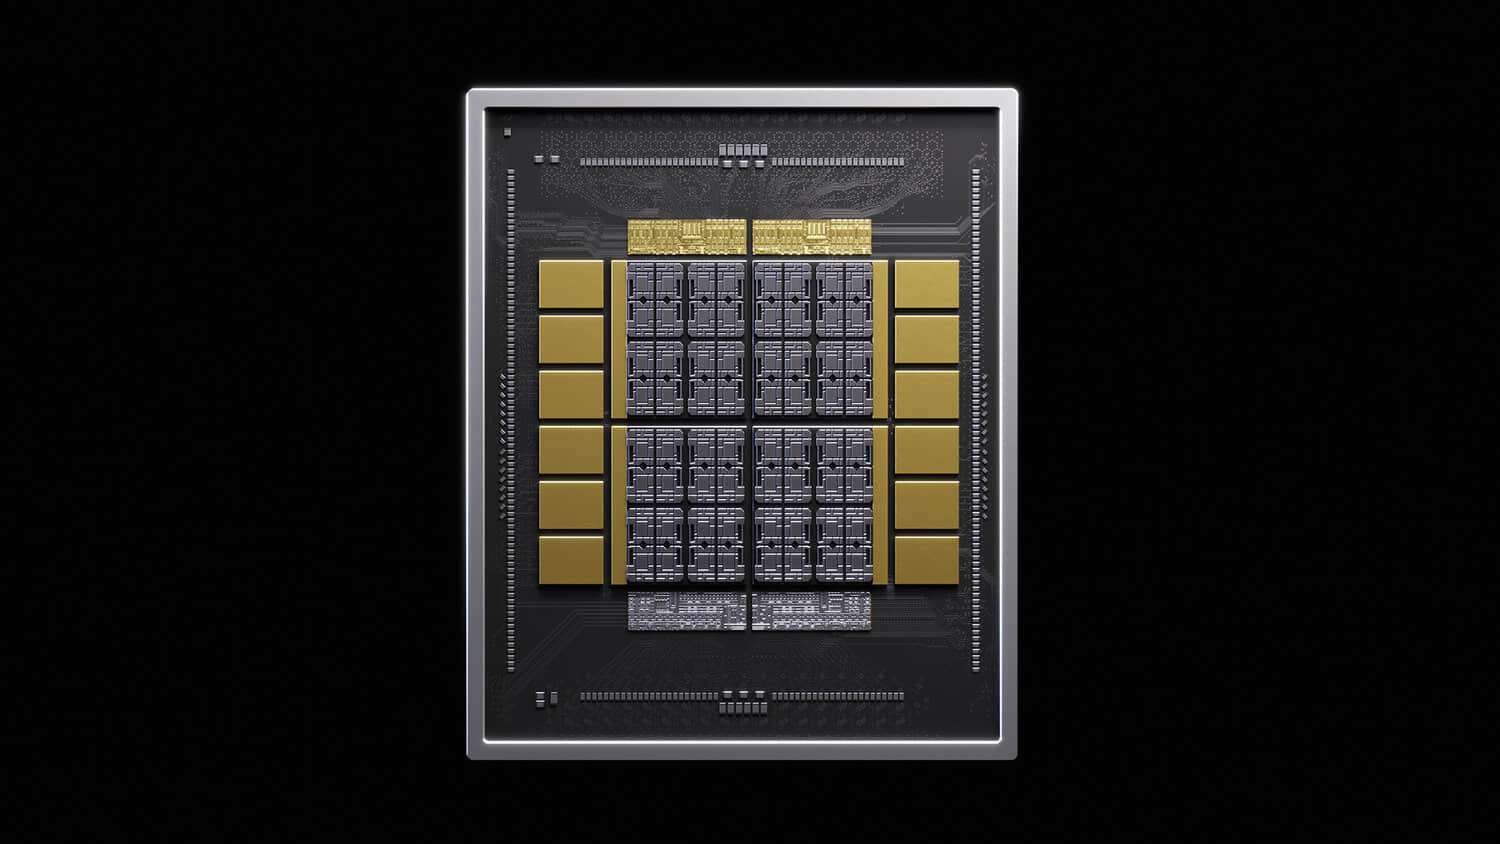
NVHBM是英伟达与亚马逊旗下Annapurna Labs联合设计的定制HBM解决方案,旨在加速未来智能体及具身AI工作负载的DRAM性能
NVHBM DRAM解决方案是NVLink Fusion的延伸,在模型规模急剧膨胀、步入万亿参数时代、内存带宽变得至关重要的当下,它为XPU提供了更高的内存性能和效率。
英伟达表示,其NVHBM解决方案比标准HBM解决方案提供更好的带宽和效率,其做法是将内存控制器从XPU上移出,直接置于HBM的基础裸片(base die)内。我们已经看到许多内存供应商和芯片制造商正在研究类似的解决方案。
高通(Qualcomm)的HBC等解决方案采用了类似的技巧,但使用的是标准LPDDR DRAM堆栈;而三星(Samsung)、SK海力士(SK Hynix)和美光(Micron)这三大厂商也强调了在未来产品中,将其各自的计算和内存控制器集成到HBM基础裸片中。
该技术将融入未来的GPU,内存控制器本身将由英伟达定制设计,并集成在HBM基础裸片内。据称,通过这一方案,内存带宽将提升30%以上,而功耗将比标准的HBM4E解决方案降低15%。将内存控制器从XPU上移除,还能为主芯片节省多达25%的裸片面积,这部分空间可用于增加额外的计算能力。
与JEDEC HBM4E标准相比,该设计将PHY及支持区域面积减少了多达67%。更窄的接口还简化了中介层布线,在整个布局中提供了多达80%更多的可用硅面积。
NVHBM为AI加速器项目带来了三大平台级优势:
带宽:相比标准HBM4E,内存带宽提升多达30%
面积:更高效的接口连接使计算裸片面积增加多达25%,用于扩展XPU功能
功耗:相比标准HBM4E,HBM功耗降低多达15%,在数千个XPU上可累计实现显著节能
在采用方面,英伟达正在建立一项标准的NVHBM实施方案,该方案将由多家内存供应商提供。这将有助于减少跨多个供应商进行内存设计集成和资质认证所需的工程投入。加入NVLink Fusion生态系统的成员也将能够更快地将定制AI芯片推向市场。
亚马逊旗下Annapurna Labs副总裁纳菲亚·布沙拉(Nafea Bshara)表示:“NVHBM代表了推进高带宽内存性能与效率的一种全新架构方法。我们期待通过这项技术合作,惠及未来的AWS基础设施设计。”
首批采用英伟达NVHBM的合作伙伴之一是亚马逊旗下的Annapurna Labs,该公司将与英伟达合作,将NVHBM技术和NVLink扩展架构进行集成,以提升AI工作负载的性能和效率。下一代AWS Trainium芯片(从Trainium4开始)将使用NVLink Fusion,在机架级统一架构下将英伟达GPU与亚马逊芯片连接起来。
由于英伟达已提到其Feynman GPU将采用定制HBM,我们可以预期该系列将在2028年发布时成为首批采用NVHBM的产品。