AMD今天提出了雄心勃勃的主张,宣称其机架级AI解决方案在追求2030年宏大目标的道路上持续实现快速能效提升。该目标旨在将多达570个基于MI300X的机架的性能足迹,压缩进仅两个计划于2030年推出的新机架之中。
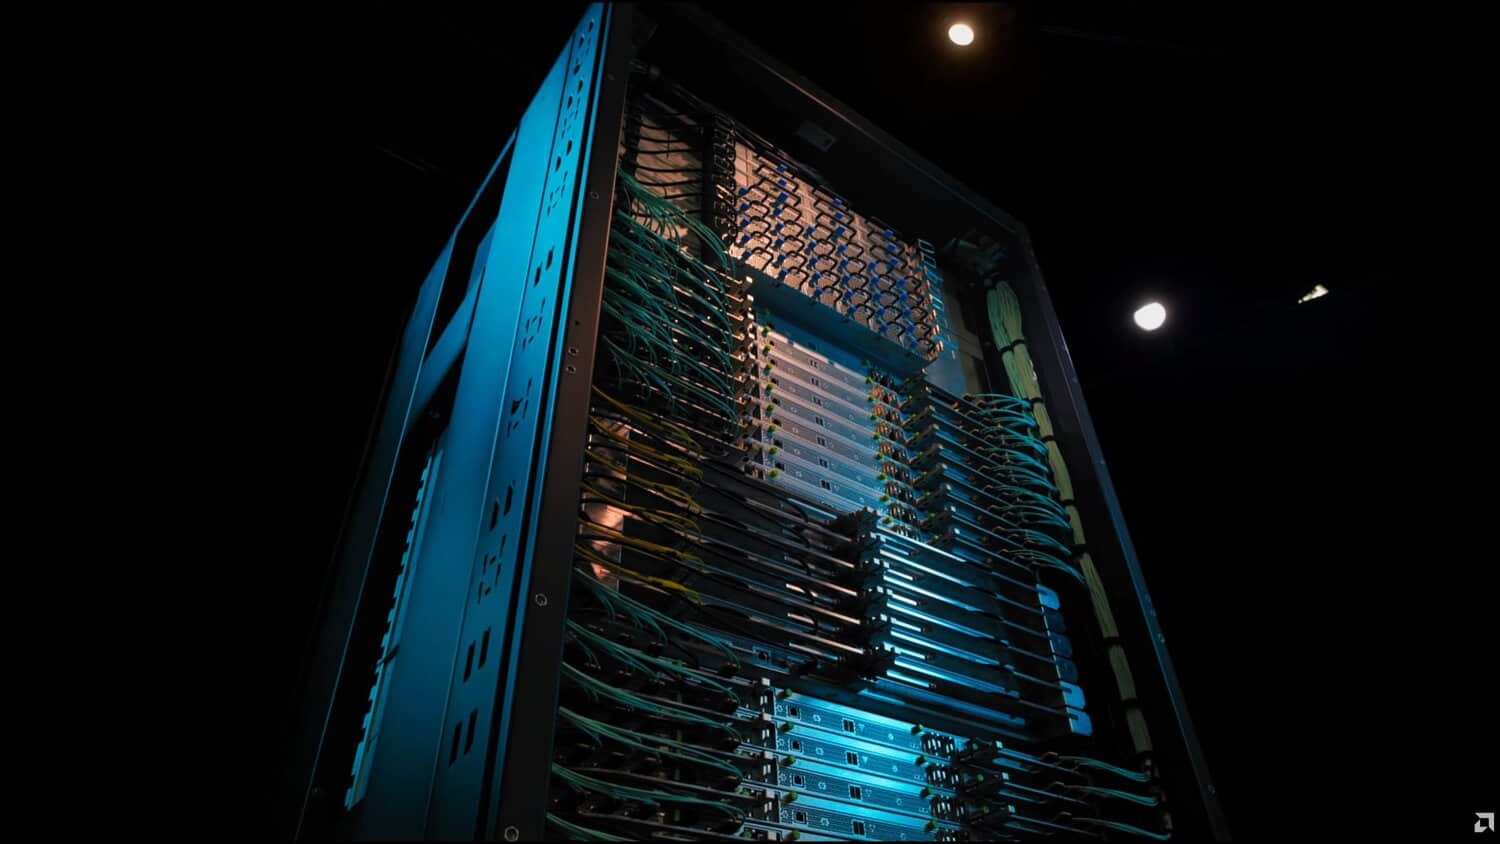
AMD声称,其2030年推出的AI机架能效将比2024年投入量产的MI300X机架提升20倍。
AMD今日披露了一些非常有趣的数据,指出其“截至2026年年中,AI能效预计已实现4倍提升,超出了该阶段设定的3倍预期目标,并且是该时间点历史趋势线的两倍以上。”此外,该公司表示,“正在朝着2030年目标稳步迈进,该目标旨在为AI训练和推理实现机架级能效的20倍提升。”
AMD计划通过以下方式实现这一壮举:
采用先进制程,在下一代AI处理器上集成数十亿个更多晶体管。
将高带宽内存(HBM)物理上更靠近处理核心放置。
构建极速内部网络(如UALink),使机架内的芯片能够即时共享工作负载。
优化软件,使芯片不会浪费电力计算无用的后台任务。
即便如此,或许整篇新闻稿中最引人注目的陈述是,AMD现在声称,“预计2030年的两个AMD机架将提供与2024年的570个机架相同的算力,从而实现使用阶段电力20倍的削减和碳强度28倍的降低。”
让我们解析一下这个陈述。MI300X AI加速器于2024年投入量产。因此,我们可以推测AMD是使用基于这些GPU的机架作为参考点的。
如果仅两个计划于2030年推出的AI机架就能提供与570个基于MI300的机架相同的性能,那么对于相同的工作负载,有效机架数量减少了285倍(570/2)。然而,AMD声称能耗仅会下降20倍。
这表明,每个计划于2030年推出的AI机架将消耗每个基于MI300X的AI机架14.25倍(285/20)的功率负载,后者需要的功率在40千瓦至125千瓦之间。综合这些信息,这意味着AMD的每个2030年推出的AI机架将消耗570千瓦至1781.25千瓦之间的功率。
当然,AMD已经通过刚刚推出的Helios机架朝着其机架级解决方案的密集化迈出了重要一步,这是该公司为AI工作负载提供的首个全栈式产品,其特性包括:
AMD Instinct MI455X GPU
第六代AMD EPYC CPU
AMD Pensando AI网络接口卡(NIC)
AMD Pensando DPU
AMD Infinity Fabric
AMD ROCm软件栈